📌CLEAR измерила налог на токенизатор в разных языках Объединение Coalition for Language Equity in AI Research (CLEAR), опубликовало первое из своих исследований языкового равенства. Поставщики моделей берут плату за токен независимо от языка, а токенизаторы обучены в основном на английском и десятке высокоресурсных языков, поэтому текст на остальных распадается на более мелкие куски и обходится дороже при том же смысле. На одну фразу токенизатор GPT-5 расходует 13 токенов в английском варианте, 26 в малаялам и 78 в амхарском, потому что каждый знак эфиопского письма разбивается на два токена по одному байту. Ввод на амхарском выходит в шесть раз дороже английского при том же содержании и почти том же числе символов. Замеры проводили на наборе фраз FLORES-200, в анализ взяли 203 пары языка и письменности. Главная метрика - отношение числа токенов у самого дорогого языка к самому дешёвому, в дополнение считали коэффициент Джини, взятую из экономики меру неравномерности распределения, которой обычно описывают расслоение доходов. CLEAR придумала шкалу оценки: до трёх раз A, до шести B, до девяти C, до двенадцати D, выше - F. 🟡 Результаты На двадцати самых представленных в интернете языках модели почти равны между собой, разброс от 1,5 до 3,1 раза. На всех 200 языках единственная модель, кто получил высший грейд А - это переводческая NLLB-200, собранная под 200+ языков изначально. Gemini и Gemma получили оценку B. Китайский стек (Qwen 3, DeepSeek V4.1 Flash и Kimi K3) вместе с Fable 5, Opus 4.8 и Llama 4 Scout - D , у GPT-5 - F. 🟡Письменность важнее числа говорящих Латинские языки экономнее даже при малом распространении - астурийский в данных Common Crawl не встречается, но выигрывает от латиницы и родственных романских языков. Хуже всего приходится бирманскому, тибетскому, тифинагу, кхмерскому, лаосскому и ол-чики. Под налог попадают и крупные языки - урду с 288 млн говорящих, бенгальский с 266 млн, панджаби с 200 млн. Кроме цены авторы называют ещё два следствия, которые идут от того же лишнего объёма токенов: 🟠задержка ответа растёт, потому что на тот же текст модель считает больше токенов; 🟠полезная ёмкость контекста уменьшается - в редком языке в те же номинальные 128 тысяч токенов влезает лишь часть текста, который по-английски уместился бы целиком. От ИИ-вендоров CLEAR просит публиковать обе метрики в карточках моделей, закладывать долю языков в словарь следующего поколения токенизаторов и, поскольку токенизатор до обучения новой базовой модели не поменять, прямо сейчас нормировать цену по символам. Код для запуска теста на других моделях лежит в репозитории проекта. Продолжение про равенство качества ответов по языкам CLEAR обещает опубликовать позже. @ai_machinelearning_big_data
Материал бастапқы дереккөзден алынған:
Telegram — AI Machine Learning Big Data
Толық мәтінді Telegram — AI Machine Learning Big Data сайтында оқуТақырып орыс тіліндеCLEAR измерила налог на токенизатор в разных языках
📌CLEAR измерила налог на токенизатор в разных языках Объединение Coalition for Language Equity in AI Research (CLEAR), опубликовало первое из своих исследований языкового равенства. Поставщики моделей берут плату за токен независимо от языка, а токенизаторы обучены в основном…
AI қорытындысы: Басты тезистер
- 📌CLEAR измерила налог на токенизатор в разных языках Объединение Coalition for Language Equity in AI Research (CLEAR), опубликовало первое из своих исследований языкового равенства
- Поставщики моделей берут плату за токен независимо от языка, а токенизаторы обучены в основном…
CLEAR измерила налог на токенизатор в разных языках
Ұқсас материалдар

OpenAI ChatGPT іздеуде Google-ды қуып жететінін айтады
Көптеген топтарда "Chat сұрауы" "Google оны" ауыстырды және бұл OpenAI жаңа хабарландыруында көрсетілген: ChatGPT арқылы орындалатын іздеу сұрауларының көлемі қазір Google арқылы іске қосылған көлемнің 20 пайызына тең. Адам Фрай, OpenAI-тің ChatGPT-тің тұтынушылық өнімінің жетекшісі,…
Дұрыс GPT
GPT6 Astra шын мәнінде схемалық тақтаны жасады. Бұл жынды емес пе? [музыка] Жалаңашқа ұқсама. Барынша тырыс, Джастин. Менің атым Джастин Линн. Мен OpenAI зерттеу тобында жұмыс істеймін. Осы жобамен мен Astra-мен не істеп жатқанымызды көрсеткім келді, бұл ...
Qodo компания контекстін Codex кодын шолуға әкеледі
Qodo Codex плагині компания контекстін, код базасының стандарттарын және әзірлеу жұмыс процесіне тәуелсіз шолуды ұсынады. Ол әзірлеушілерге репозиторийлердегі қателерді анықтауға көмектеседі, мұнда өзгерту бір код базасында дұрыс көрінуі және басқасында қызметті бұзуы мүмкін. Behind the Build бөлімінде негізін қалаушы…
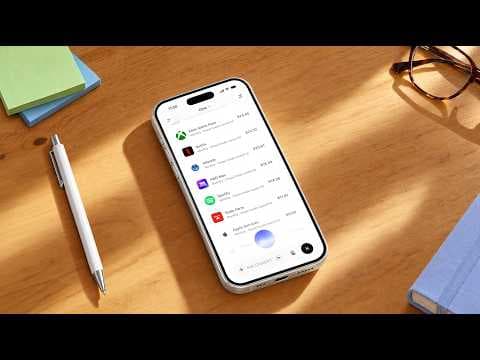
ChatGPT Voice енді Қаржы бөлімінде
Сәлем, сіз маған жазылымдарым мен қайталанатын төлемдерім туралы қысқаша мәлімет бере аласыз ба? Және ұқсас болуы мүмкін кез келген төлемдерді белгілей аласыз ба? >> Иә, мен қараймын. Жарайды, міне, толық қайталанатын төлемдер көрінісі, осылайша сіз қатарлас салыстыра аласыз. Ең айқын сәйкестік - сақтандыру ...