Материал бастапқы дереккөзден алынған:
YouTube — PyTorch Official
Толық мәтінді YouTube — PyTorch Official сайтында оқуМатериал ашық дереккөздерден жиналған. Оның орналастырылуы сіздің құқықтарыңызға тиіп жатса → Ақпаратты жою
Тақырып ағылшын тіліндеMoRI + vLLM: Wide Expert Parallelism and RDMA KV-Cache Transfer for Disaggregated MoE Serving on AMD
Running large Mixture-of-Experts models across pods creates two major challenges: expert dispatch and combine traffic, and moving the KV cache between prefill and decode. At North America 2026, Ravi Gupta, Rishi Madduri, and Shiksha Patel of AMD will present “MoRI + vLLM: Wide…
AI қорытындысы: Басты тезистер
- Running large Mixture-of-Experts models across pods creates two major challenges: expert dispatch and combine traffic, and moving the KV cache between prefill and decode
- At North America 2026, Ravi Gupta, Rishi Madduri, and Shiksha Patel of AMD will present “MoRI + vLLM: Wide…
Ұқсас материалдар

RUЧеловек, изменивший мир искусственного интеллекта, едет в Казахстан
23 октября Астана впервые примет Дженсена Хуанга, основателя и генерального директора NVIDIA. Его визит интересен не только масштабом компании. Хуанг предлагает новое понимание мировой экономики, в которой искусственный интеллект становится производительной силой, вычислительные…
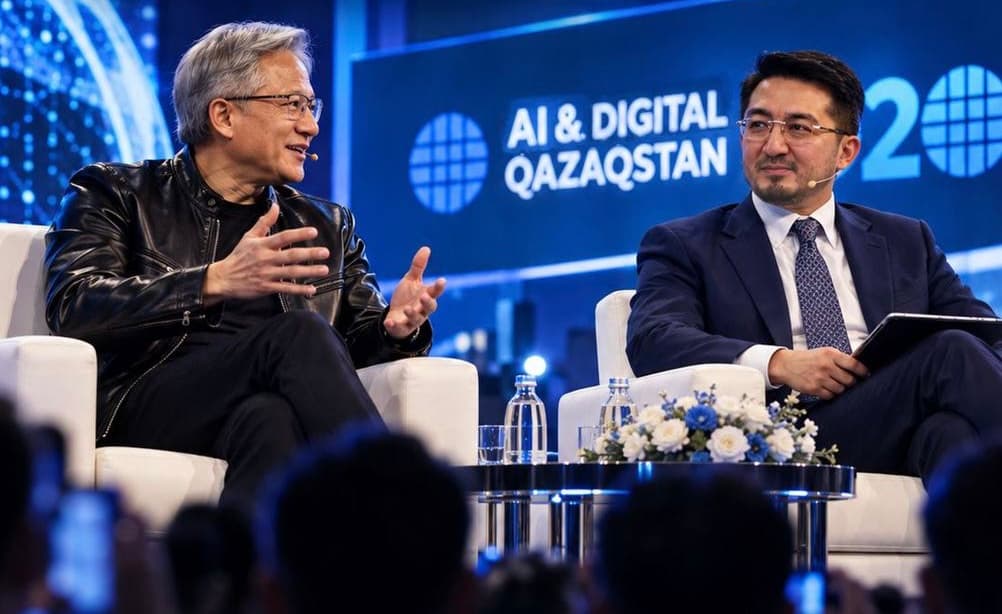
NVIDIA басшысы Дженсен Хуанг 23 қазанда Астанада сөз сөйлейді
NVIDIA компаниясының негізін қалаушы әрі бас директоры Дженсен Хуанг 23 қазанда Астанада жасанды интеллекттің болашағына арналған ашық пікірталасқа қатысады, деп хабарлайды Tech-news. Fireside Chat форматындағы кездесуде ол Қазақстан Премьер-министрінің орынбасары, Жасанды…
DeepSeek AI үлгілерін басқаруға арналған DeepInfer бастапқы кодын ашты.
DeepSeek AI үлгілерін басқаруға арналған DeepInfer бастапқы кодын ашты. Бұл DeepSeek-V4.1-Flash жоғары өнімділікпен және ең аз кідіріспен жұмыс істеуін қамтамасыз етеді. Ең бастысы: - Қорытындыны жылдамдату - аз уақыт ішінде көбірек сұраулар. - Тиімді...

ENA visit to Samsung’s massive new semiconductor hub
_____________ THE PLACE Pyeongtaek, South Korea Generative AI models run on powerful chips known as GPUs, which depend on stacks of specialized memory chips packaged with the processor. To meet growing demand for memory, Samsung is building a massive new semiconductor…