Охотники за ошибками теперь могут зарабатывать до 172 000 долларов от OpenAI, поскольку компания усиливает безопасность
OpenAI в четыре раза увеличивает выплаты за обнаружение ошибок и запускает новую программу внутренней безопасности. Статья «Охотники за ошибками теперь могут зарабатывать до 172 000 долларов на OpenAI, поскольку компания усиливает безопасность», впервые появилась на сайте The Decoder.
Кратко от AI: Главные тезисы
- OpenAI в четыре раза увеличивает выплаты за обнаружение ошибок и запускает новую программу внутренней безопасности
- Статья «Охотники за ошибками теперь могут зарабатывать до 172 000 долларов на OpenAI, поскольку компания усиливает безопасность», впервые появилась на сайте The Decoder.
Охотники за ошибками теперь могут зарабатывать до 172 000 долларов от OpenAI, поскольку компания усиливает безопасность
Похожие материалы
Дарим 10 подписок ChatGPT
Дарим 10 подписок ChatGPT В честь открытия магазина подписок и цифровых товаров PARAGON.STORE делимся нашим товаром с теми, кому повезёт: 5 × ChatGPT Plus и 5 × ChatGPT Go на месяц. Как участвовать: ▶️Подпишись на канал ▶️Напиши в комментариях под этим постом, для какой задачи…
Выпуск декларативных агентов: что нового и что дальше — саммит Copilot Dev Camp, осень 2026 г.
Большое спасибо. Привет всем. Еще раз приветствуем следующий сегмент. Откуда бы вы ни присоединились, спасибо, что тусовались с нами. Это продлится еще, может быть, два-три часа, может быть, два часа. Меня зовут Рабия, я сторонник облачных технологий здесь, в Microsoft, и ко мне присоединилась Рахит…
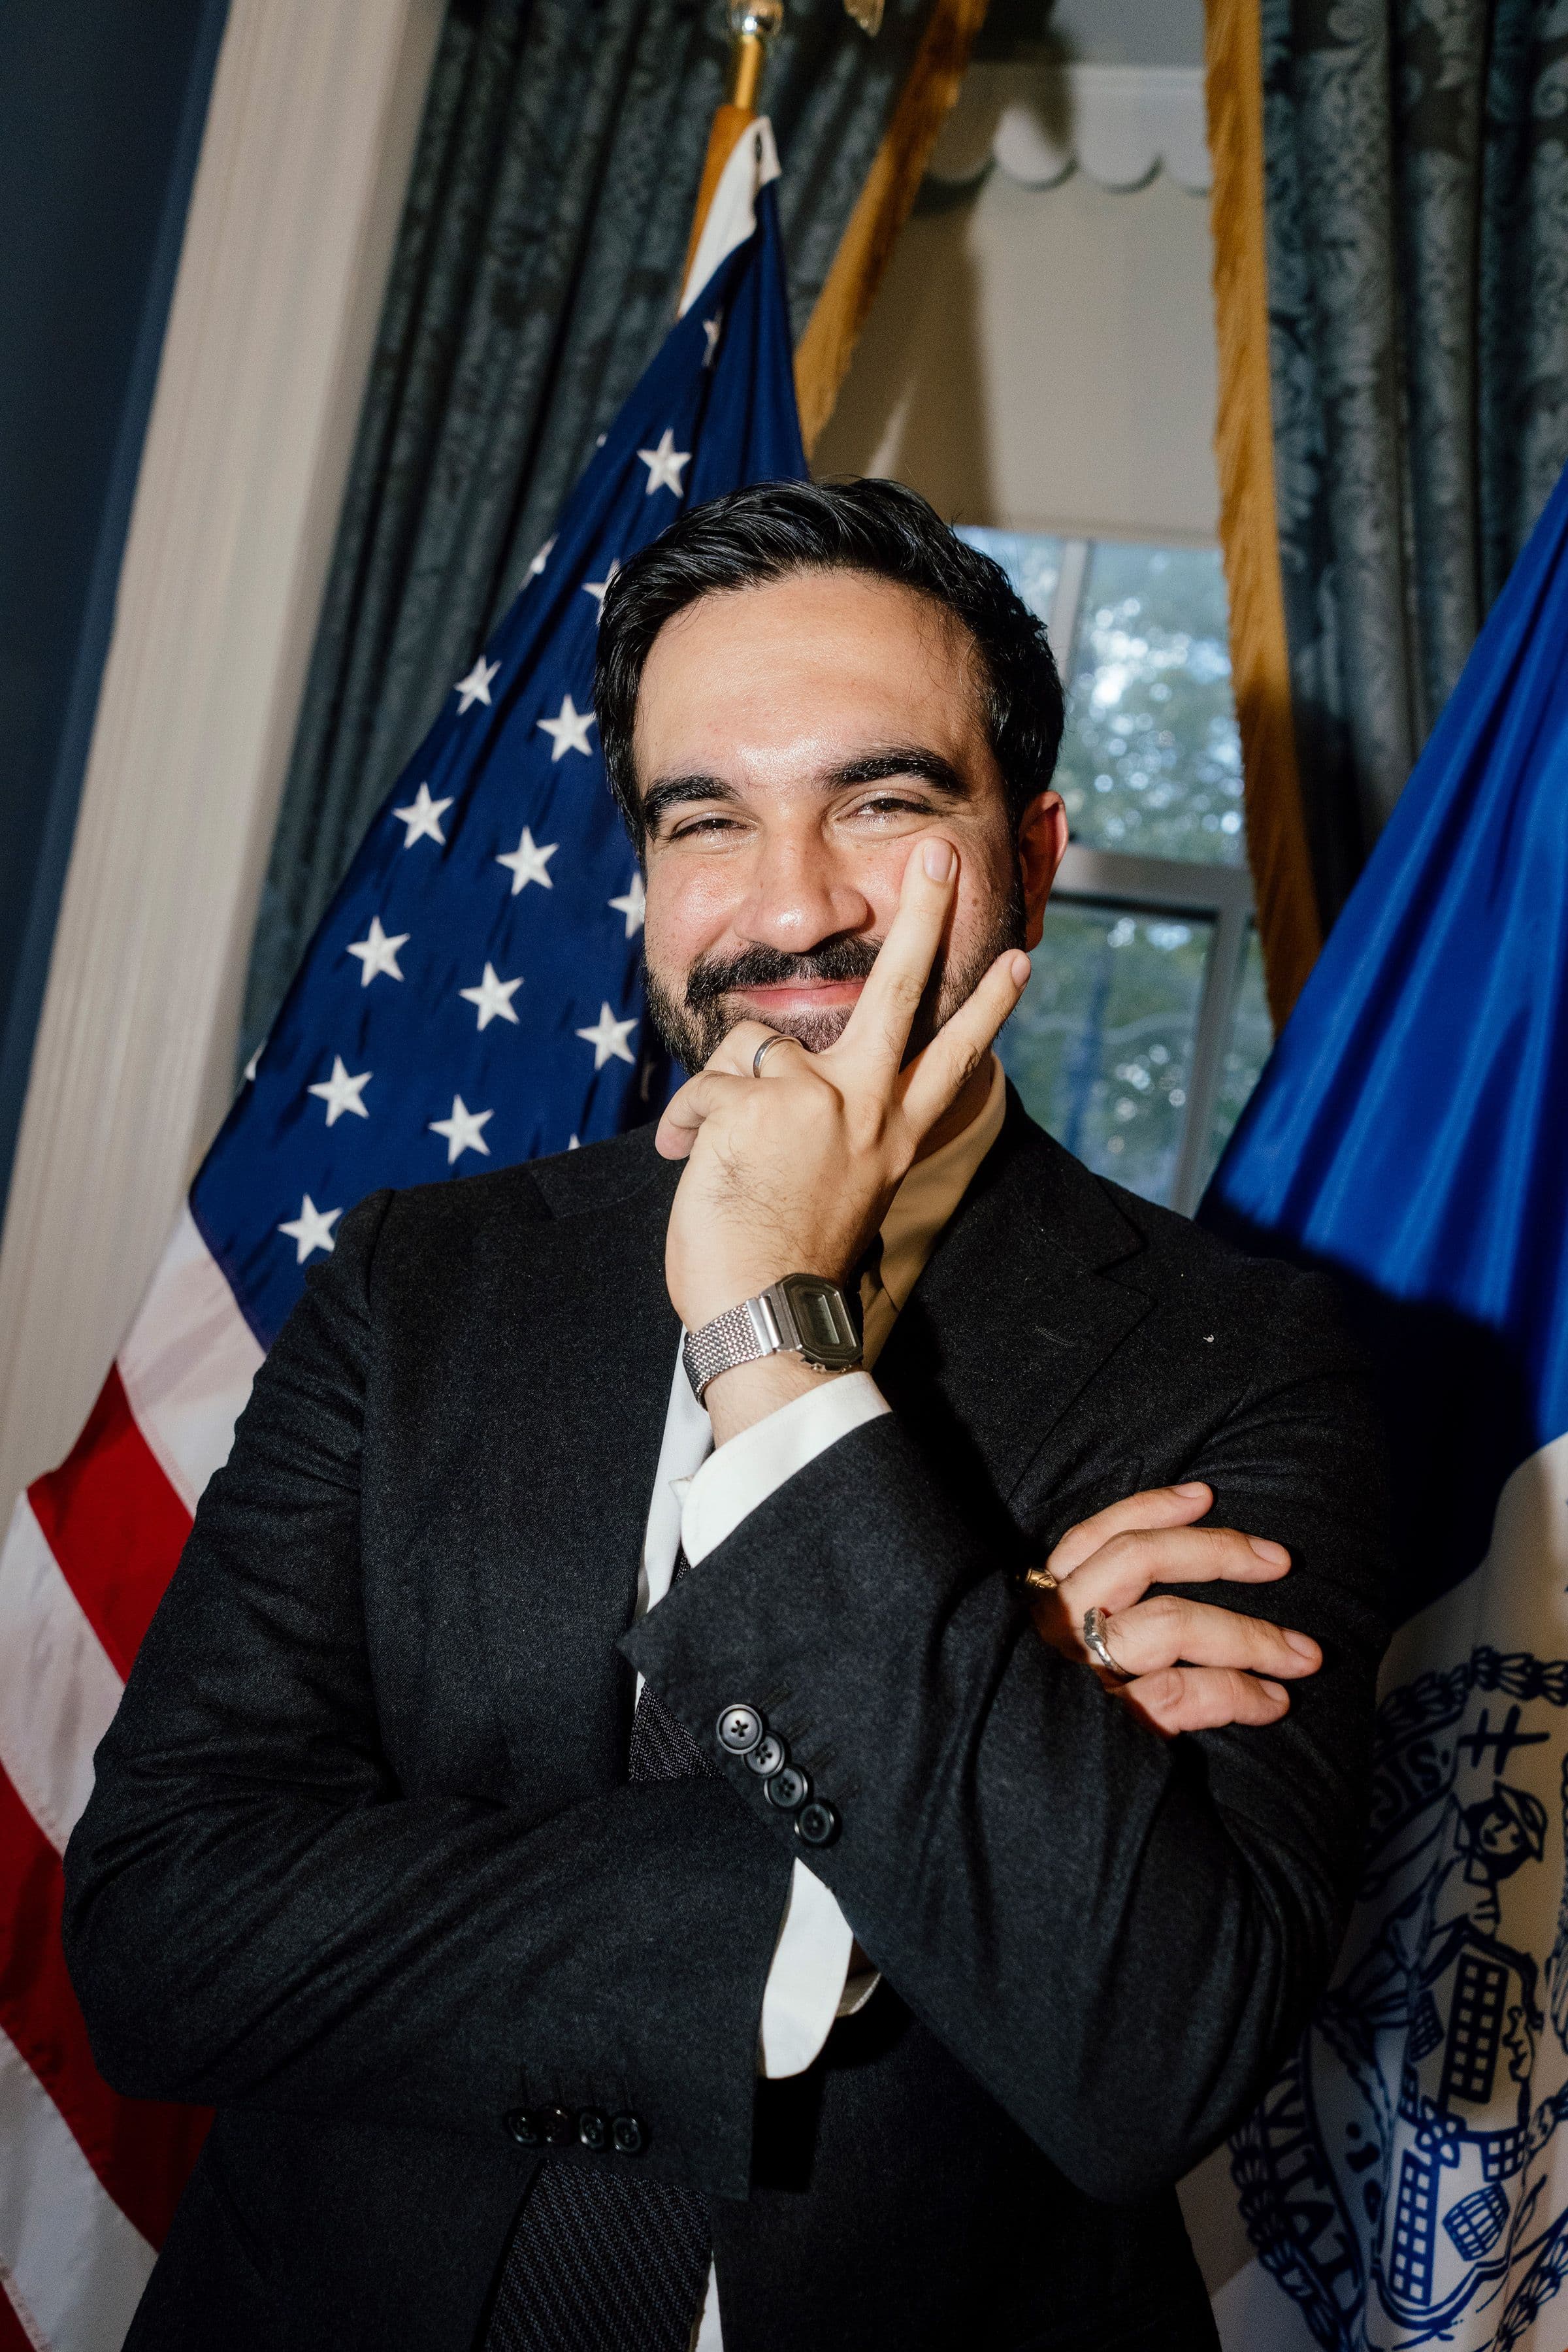
Наш риск — их награда»: Зоран Мамдани об искусственном интеллекте и центрах обработки данных
В преддверии промежуточных выборов WIRED поговорил с мэром Нью-Йорка о центрах обработки данных, искусственном интеллекте в школах и будущем Демократической партии.

Как «теория обратной игры» может держать агентов ИИ под контролем
Новый подход, известный как «теория обратной игры», направлен на создание стимулов для мощных моделей ИИ, которые делают следование правилам наиболее рациональным выбором. Поскольку модели искусственного интеллекта становятся все более функциональными, исследователи в области безопасности стараются обеспечить их «соответствие» человеческим желаниям — сделать…