Как сообщает AWS Machine Learning, инженеры всё чаще используют инструменты помощи в программировании для ускорения своих рабочих процессов. Сегодня Amazon SageMaker AI представил оптимизированный генеративный AI-интерфейс, который включает навык aws-ai-ml, доступный через Toolkit для AWS. Этот навык предоставляет кодирующим агентам, таким как Kiro, Claude Code и Codex, глубокую экспертизу в оптимизации вывода и бенчмаркинге. Установив этот навык, ваш существующий агент сможет проводить бенчмаркинг конечных точек, рекомендовать конфигурации развертывания, сравнивать результаты производительности и генерировать исполняемый код SageMaker Python SDK v3 от вашего имени. Навык aws-ai-ml представляет собой набор инструментов, который подключается к любому кодирующему агенту, поддерживающему Протокол Контекста Модели (MCP), превращая его в эксперта по оптимизации вывода SageMaker AI. В этом посте мы подробно расскажем о возможностях навыка, о том, как его настроить и как он поможет вам быстрее перейти от модели к производству. Основная задача заключается в преодолении разрыва между намерениями и инфраструктурой. Amazon SageMaker AI поддерживает серверное хостингование в реальном времени, пакетный и асинхронный режимы. Он предлагает ресурсы по запросу и резервированные мощности, разнородные экземпляры, изоляцию виртуальной частной сети (VPC), автоматическое масштабирование и интеграцию с каждым путем обучения SageMaker AI. Хотя область применения широка и глубокая, большинство инженеров не знают, какая семейство экземпляров или контейнер для обслуживания лучше всего удовлетворит их потребности. Они приходят с конкретным случаем использования: целевыми показателями производительности, которые они хотят достичь, бюджетом, в рамках которого им нужно работать, или моделью, которую они хотят оценить перед тем, как перейти к производству. Опыт работы с оптимизированным генеративным AI-интерфейсом SageMaker AI закрывает этот разрыв. Вы сообщаете агенту, что хотите достичь, и он производит исполняемый код SageMaker Python SDK v3, который вы можете просмотреть, изменить и запустить в своей среде. Агент задает целевые уточняющие вопросы, генерирует код, основанный на реальных бенчмарках и измеренных данных производительности, и адаптируется к вашим бизнес-ограничениям так же, как это сделал бы архитектор решений. При этом вы сохраняете контроль. Каждый шаг виден в реальном времени и представлен в виде читаемого кода. Ничто не происходит за непрозрачным пользовательским интерфейсом. Чтобы начать, вы можете установить навык aws-ai-ml через Toolkit для AWS на своем локальном компьютере или использовать его в пространстве JupyterLab Amazon SageMaker Studio. В любом случае вы сможете перейти от нуля к рабочему взаимодействию за 10 минут. Опция A: Использование с любым кодирующим агентом (Kiro, Claude Code, Codex или любым совместимым с MCP агентом). Шаг 1: Установите Toolkit для AWS. Если вы еще не сделали этого, настройте Toolkit для AWS, что требует установки AWS Command Line Interface (AWS CLI) версии 2.35 или выше и uv. Команда aws configure agent-toolkit автоматически обнаружит ваши агенты, установит навыки и настроит сервер AWS MCP. Шаг 2: Установите навык aws-ai-ml. Добавьте навык оптимизированного генеративного AI-интерфейса SageMaker AI в ваш агент с помощью команды: npx skills add aws/agent-toolkit-for-aws/skills/aws-ai-ml. Шаг 3: Подтвердите и начните. Откройте панель чата вашего кодирующего агента и спросите: «Какие навыки доступны?» Вы должны увидеть aws-ai-ml в списке. После подтверждения опишите ваше намерение на естественном языке. Теперь ваш кодирующий агент имеет встроенную экспертизу в оптимизации вывода SageMaker AI. Предварительные условия: ваши учетные данные AWS должны иметь разрешения на вызов API SageMaker AI (создание конечных точек, запуск бенчмарков и рекомендательных заданий). Навык генерирует код, который выполняется под вашими учетными данными. Дополнительная конфигурация AWS Identity and Access Management (IAM) для самого навыка не требуется. Примечание: для Kiro и Claude Code агенты могут обнаруживать навыки во время выполнения. Они могут искать и загружать навыки по запросу через сервер AWS MCP, без какой-либо локальной установки. Спросите вашего агента: «Поиск навыков AWS, связанных с базами данных». Обратитесь к справочному руководству для обнаружения навыков во время выполнения. Опция B: Использование в Amazon SageMaker Studio. Если вы предпочитаете работать в управляемой среде JupyterLab, вы можете использовать навык в Amazon SageMaker Studio с предварительно настроенным образом. Шаг 1: Откройте Amazon SageMaker Studio. Перейдите в Amazon SageMaker Studio в вашем целевом аккаунте AWS и регионе. Выберите ваш домен Studio и запустите IDE Studio из вашего профиля пользователя. Шаг 2: Создайте пространство JupyterLab. На главной странице Studio выберите JupyterLab, затем выберите Создать пространство JupyterLab. Назовите пространство (например, my-inference-opt) и оставьте настройки общего доступа приватными (навыки синхронизируются только в частных пространствах). В меню Изображение выберите изображение, которое включает навык оптимизированного генеративного AI-интерфейса SageMaker AI. Это изображение поставляется с предварительно настроенным навыком агента aws-ai-ml и всеми необходимыми зависимостями. Выберите Запустить пространство и дождитесь его загрузки (5–10 минут в первый раз). Примечание: используйте новое пространство. Переиспользованное пространство с локально измененной версией навыка может не получить предварительно настроенное изображение. Шаг 3: Откройте JupyterLab и запустите терминал. После загрузки пространства откройте JupyterLab и выберите Терминал. Шаг 4: Авторизуйте вашего кодирующего агента. В терминале аутентифицируйтесь с вашим кодирующим агентом, используя вашего поставщика идентификации. Например, для Kiro: kiro-cli login --license pro --identity-provider <ваш-IdP-начальный-URL> --region us-east-1 --use-device-flow. Шаг 5: Подтвердите и начните. Откройте панель чата вашего кодирующего агента и спросите: «Какие навыки доступны?» Вы должны увидеть aws-ai-ml в списке. После подтверждения опишите ваше намерение на естественном языке. Устранение неполадок: если агент сообщает, что навыки недоступны, убедитесь, что ваше пространство установлено как частное. Вы также можете проверить в терминале: ls ~/.kiro/skills/. Если этот каталог пуст, но /etc/sagemaker/skills/ содержит файлы навыков, выполните команду restart-jupyter-server, обновите страницу и повторите попытку. Что вы можете сделать. Агентный опыт охватывает следующие возможности на протяжении всего жизненного цикла оптимизации вывода. Вам не нужно знать, какую возможность вызывать. Опишите, что вы хотите, и ваш агент определит следующий шаг или задаст уточняющие вопросы, если что-то неясно. Бенчмаркинг существующей конечной точки. Если у вас уже есть модель, развернутая на конечной точке SageMaker AI, вы можете попросить агента провести бенчмаркинг. Сообщите агенту, какую конечную точку вы хотите протестировать, и он сгенерирует Python-ноутбук, который запускает нагрузочное тестирование с использованием API Workload.synthetic() и start_benchmark() из SageMaker Python SDK. Перед запуском любого бенчмарка агент подтверждает, что ваша конечная точка безопасна для нагрузочного тестирования, поскольку бенчмаркинг создает реальный трафик к работающей конечной точке. После завершения бенчмарка вы получите количественный отчет о производительности с: Пропускная способность: запросы в секунду, токены на выходе в секунду. Задержка: p50, p99, время до первого токена, задержка между токенами. Конкуренция: количество одновременно поддерживаемых запросов. Это измеренные значения с реальной нагрузки на реальную инфраструктуру, а не оценки. Агент также рекомендует механизмы улучшения (например, предзаполнение декодирования) для повышения производительности. Пример запроса: «Проведите бенчмаркинг моей конечной точки Llama на SageMaker AI. Найти правильный тип экземпляра для вашей модели. Если у вас есть модель и вам нужно найти правильный тип экземпляра для ее развертывания на SageMaker AI, сообщите своему агенту. Не имеет значения, где находится ваша модель или как вы ее получили: уточненная или пользовательская модель в Amazon Simple Storage Service (Amazon S3): вы обучили или скачали модель и сохранили ее в S3. Укажите URI S3 и вашу цель оптимизации. Пример запроса: «Я хочу найти самый дешевый тип экземпляра для развертывания моей уточненной модели на SageMaker.» Общественно доступная основная модель из Amazon SageMaker JumpStart: вы хотите развернуть основную модель (FM) из каталога JumpStart, затем предоставьте идентификатор модели. Пример запроса: «Найдите лучший экземпляр для модели huggingface-reasoning-qwen3-8b на SageMaker AI.» Модель на Hugging Face Hub: вы хотите использовать модель, размещенную на Hugging Face. Укажите имя модели. Для закрытых моделей (таких как варианты Llama) ваш агент отображает условия лицензии и просит вас их принять и предоставить ваш токен Hugging Face. Пример запроса: «Я хочу развернуть модель Llama с Hugging Face Hub. Какой самый дешевый вариант?» В каждом случае ваш агент генерирует код, который оценивает вашу модель по отношению к кандидатам экземпляров и конфигурациям, затем представляет ранжированные варианты развертывания с конкретными показателями производительности: пропускная способность, задержка, временные процентные показатели и конкуренция. Вы выбираете на основе ваших требований к стоимости и производительности. Сравнить результаты бенчмарка. Если вы провели несколько бенчмарков (например, до и после изменения конфигурации или на двух типах экземпляров), вы можете попросить агента сравнить их. Укажите два имени заданий бенчмарка, и агент сгенерирует сравнение, вычисляющее дельты по ключевым метрикам: пропускная способность, задержка, временные процентные показатели и время до первого токена. Результаты показывают процентные изменения, где положительное значение означает улучшение, что дает вам единый, интерпретируемый обзор того, улучшила ли ваша смена производительность, ухудшила ее или не имела значительного эффекта. Если один из заданий бенчмарка не существует, агент предлагает сначала его запустить, прежде чем продолжить сравнение. Пример запроса: «У меня есть два задания бенчмарка, и я хочу их сравнить. Какой из них быстрее?» Результаты бенчмарка. Эта таблица сравнивает две развернутые модели на одной и той же нагрузке бенчмарка (512/256 токенов, конкуренция 4). Столбец Δ% показывает, насколько быстрее модель B (Qwen3-8B) по сравнению с моделью A (Qwen3-1.7B) по каждой метрике. Положительное значение означает, что модель B лучше. Метрика Qwen3-1.7B (Модель A) Qwen3-8B (Модель B) Δ% Пропускная способность выходных токенов 188.2 токенов/с 271.2 токенов/с +44.1% ✅ Пропускная способность на пользователя 47.5 токенов/с 69.4 токенов/с +45.9% ✅ Пропускная способность запросов 0.736 req/s 1.08 req/s +46.7% ✅ Задержка между токенами 20.9 мс 14 мс +33.0% ✅ Задержка запроса 5,382 мс 3,658 мс +32.0% ✅ Время до первого токена 67.5 мс 166.3 мс −146.5% ❌ Обе модели работают на разном оборудовании. Qwen3-8B использует 4-GPU ml.g5.12xlarge (4x A10G), в то время как Qwen3-1.7B использует один L4 GPU (ml.g6.4xlarge). Дельты отражают примерно 4x вычислительные мощности, а не только сами модели. Вывод: Qwen3-8B обеспечивает примерно на 44–47 процентов большую пропускную способность и меньшую задержку, в значительной степени благодаря дополнительным вычислительным мощностям GPU. Qwen3-1.7B выигрывает только по времени до первого токена, ожидаемое преимущество меньшей модели на одном GPU. Сводя все вместе, вам не нужно запоминать названия возможностей или знать, какой рабочий процесс запрашивать. Следующая таблица показывает, как общие запросы соответствуют результатам. Вы говорите Что вы получаете «Я уже развернул модель и хочу знать, насколько она быстра.» Количественный отчет о производительности: пропускная способность, временные процентные показатели задержки, метрики конкуренции из реальной нагрузки. «У меня есть модель в S3, и я не знаю, на каком экземпляре развернуть ее.» Ранжированные варианты развертывания с затратами, пропускной способностью и задержкой для каждой кандидатной конфигурации. «Я хочу развернуть модель JumpStart и найти самый дешевый экземпляр. У меня есть только идентификатор модели.» Ранжированные варианты развертывания, без необходимости промежуточного хранения в S3. Закрытая модель, если это необходимо. «Я провел бенчмарк до и после изменения. Какой из них быстрее?» Процентное изменение по всем метрикам, указывающее на улучшение или регрессию. «Я хочу оптимизировать модель Llama с Hugging Face Hub.» Лицензия отображена, модель помещена в S3, затем стандартный вывод рекомендаций. Если ваш запрос охватывает несколько возможностей (например, промежуточное хранение модели Hugging Face и затем получение рекомендаций по развертыванию), агент естественным образом связывает их в одном разговоре. Что ожидать от агента. Ваш агент, оснащенный навыком aws-ai-ml, следует нескольким поведением, которые делают опыт предсказуемым и безопасным: он запрашивает необходимую информацию. Если информация отсутствует (например, имя конечной точки или URI S3), агент просит вас предоставить ее, а не догадывается. Он подтверждает перед важными действиями. Перед запуском бенчмарка, который создает реальный трафик к рабочей конечной точке, агент предупреждает вас о последствиях и запрашивает явное подтверждение. Он сообщает, когда что-то выходит за рамки. Если вы запрашиваете что-то, что агент не может сделать (например, развертывание модели), он объясняет, что он может предложить вместо этого, например, генерировать конфигурацию развертывания, которая вам нужна. Он генерирует код SageMaker Python SDK v3. Каждый вывод — это исполняемый код, который вы можете проверить, изменить и запустить в своей среде. Для избежания постоянных затрат удалите созданные вами ресурсы: удалите конечные точки SageMaker AI, созданные во время бенчмаркинга или рекомендаций. Остановите или удалите свое пространство JupyterLab, если вы использовали SageMaker Studio. Удалите объекты S3, хранящиеся в вашем стандартном бакете SageMaker AI, созданные во время заданий бенчмаркинга и рекомендаций. В заключение, навык aws-ai-ml для оптимизированного генеративного AI-интерфейса Amazon SageMaker превращает ваш существующий кодирующий агент в эксперта по оптимизации вывода SageMaker AI. Независимо от того, нужно ли вам провести бенчмарк живой конечной точки, найти самый дешевый экземпляр для вашей модели, сравнить конфигурации или подготовить модель Hugging Face для оценки, вы описываете, что хотите, и ваш агент предоставляет измеримые результаты. Чтобы начать, установите навык через Toolkit для AWS и добавьте его к кодирующему агенту, который вы уже используете, или запустите предварительно настроенное пространство JupyterLab в Amazon SageMaker Studio. Для получения дополнительной информации смотрите документацию Amazon SageMaker AI. Материал подготовлен нейросетью на основе оригинальной публикации. ИИ может ошибаться в деталях (цифры, имена, даты, цитаты) — для важной информации сверяйтесь с первоисточником.
Материал агрегирован из первоисточника:
SMNTCN (Semanticon) — глобальные новости ИИ
Читать полностью в SMNTCN (Semanticon) — глобальные новости ИИМатериал собран из открытых источников. Если размещение затрагивает ваши права → Удалить информацию
Amazon SageMaker представляет новый инструмент для оптимизации AI
Amazon SageMaker AI представил новый навык для оптимизации генеративного AI.
Кратко от AI: Главные тезисы
- Amazon SageMaker AI представил новый навык для оптимизации генеративного AI.
Amazon SageMaker представляет новый инструмент для оптимизации AI
Похожие материалы
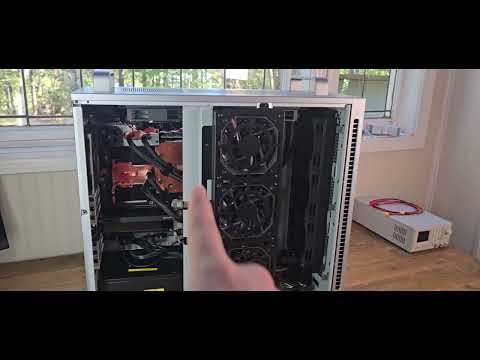
Центр обработки данных дома — графический процессор GB300 — со станцией Asus DGX (ET900N G3)
Всем, что происходит, и добро пожаловать на очень интересный обзор подхода ASUS к станции Nvidia DGX. Они называют это ET900N G3, но я буду продолжать называть его станцией DGX или для краткости станцией ASUS. У нас здесь 748 ГБ когерентной памяти. Это любезно…
Google научила ИИ-агентов самостоятельно улучшать свою работу
🤖 Google научила ИИ-агентов самостоятельно улучшать свою работу Компания открыла доступ к Harness² — системе, которая помогает ИИ-агентам повышать эффективность до 11% без переобучения самой модели. Агенты самостоятельно экспериментируют с промптами, инструментами, памятью и…
Китайский парень показал, на что способен: в одиночку использовал ИИ-агентов для атак на 1200 сайтов.
Китайский парень показал, на что способен: в одиночку использовал ИИ-агентов для атак на 1200 сайтов. Сегодня Reuters сообщило об очередном китайскоязычном хакере, который с помощью ИИ-агентов попытался атаковать более 1200 сайтов и успешно взломал сайты, связанные с более чем…

Мамдани заявляет, что федералы отказались от ответственности по ИИ, и призывает нью-йоркцев сопротивляться
Мэр Зохран Мамдани в понедельник вечером заявил, что нью-йоркцы должны противостоять нарративу о неизбежности захвата власти ИИ и требовать регулирования, защищающего общественность и возвращающего им власть.