Материал агрегирован из первоисточника:
YouTube — Hugging Face
Читать полностью в YouTube — Hugging FaceМатериал собран из открытых источников. Если размещение затрагивает ваши права → Удалить информацию
Заголовок на английскомHugging Face Journal Club: Kimi K3
Let [clears throat] me think where to start. Okay, so we've got the Kim K3 report and it's quite a beast in terms of details, which is pretty awesome. And the bits that I focused on were really just the the pre- uh sorry, the post-training parts. And even that I wasn't able to…
Кратко от AI: Главные тезисы
- Let [clears throat] me think where to start
- Okay, so we've got the Kim K3 report and it's quite a beast in terms of details, which is pretty awesome
- And the bits that I focused on were really just the the pre- uh sorry, the post-training parts
Хронология события
- Исследования
ENHugging Face Journal Club: AI Research Preference Models
- Исследования
ENHugging Face Journal Club: Direct On-Policy Distillation
- Исследования
ENHugging Face got hacked
Похожие материалы
Meta строит гигантский ИИ-суперкомпьютер почти на миллион видеоускорителей
🌐 Meta строит гигантский ИИ-суперкомпьютер почти на миллион видеоускорителей Meta рассказала о строительстве Prometheus — одного из крупнейших вычислительных комплексов для искусственного интеллекта. Он расположен в американском штате Огайо и предназначен для обучения мощных…
Сэм Альтман о личности ChatGPT (отрывок из моего интервью)
Сэм Альтман о личности ChatGPT (отрывок из моего интервью)
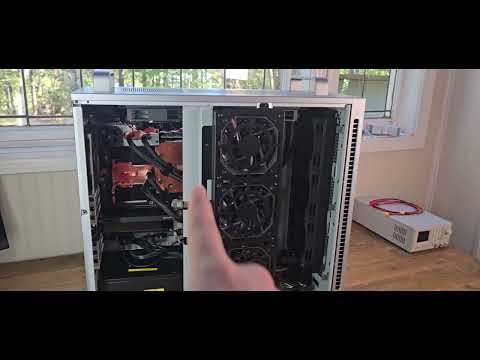
Центр обработки данных дома — графический процессор GB300 — со станцией Asus DGX (ET900N G3)
Всем, что происходит, и добро пожаловать на очень интересный обзор подхода ASUS к станции Nvidia DGX. Они называют это ET900N G3, но я буду продолжать называть его станцией DGX или для краткости станцией ASUS. У нас здесь 748 ГБ когерентной памяти. Это любезно…
Где живут блоки: Уровневая маршрутизация KV-кэша для vLLM в масштабе
Привет, я Понгуп Пак из War на PyTorch Conference North America 2026. Я представляю постер под названием «Где живёт блок». Когда GPU-память сбрасывает KV-кэш в CPU или хранилище, LMD отслеживает, где находится каждый блок, и направляет каждый запрос к своему кэшу. Вы увидите, когда CPU...