Как сообщает NVIDIA Developer, NVIDIA CUDA Tile (cuTile) представляет собой основанную на Python DSL и модель параллельного программирования для графических процессоров NVIDIA, которая автоматически использует передовые аппаратные возможности для достижения максимальной производительности при программировании на уровне тайлов. Благодаря абстракции планирования потоков и варпов с помощью высокоуровневых примитивов, ориентированных на тайлы, cuTile позволяет писать ядра GPU на Python, в то время как оптимизации компилятора автоматически нацеливаются на передовые аппаратные функции, такие как Tensor Cores. Как ранний пользователь cuTile, инженеры машинного обучения компании Jane Street реализовали Mamba-2, современную модель последовательностей, в cuTile и сотрудничали с NVIDIA для оптимизации ядер. Jane Street — это высокотехническая глобальная торговая компания, использующая глубокое обучение для инноваций в области сложных количественных исследований. В этом посте рассматриваются три пользовательских ядра, обеспечивающих прямой проход Mamba-2, и оптимизации cuTile, стоящие за ними. Для использования cuTile убедитесь, что ваша среда соответствует требованиям, изложенным в руководстве по быстрой настройке Python cuTile. Импортируйте пакет как cuda.tile и используйте его как ct в реализации ядер, представленных в этом посте. Архитектуры моделирования последовательностей сталкиваются с вычислительным компромиссом: традиционное внимание softmax быстро обучается с использованием матричного умножения, ускоряемого Tensor Cores, но при выводе требования к вычислениям и памяти увеличиваются линейно с длиной последовательности. В отличие от этого, рекуррентные нейронные сети (RNN) страдают от медленного, непараллелизуемого обучения, но требуют постоянных вычислений и фиксированного объема памяти независимо от длины последовательности. Архитектура Mamba-2 происходит из семейства моделей, стремящихся к лучшему из обоих миров. Подобно RNN, она имеет фиксированный размер скрытого состояния и рекуррентное обновление, которое может вычисляться по частям эффективно с использованием Tensor Cores. Основная рекурсия Mamba-2 представлена формулой. Интуитивно, переменная dt_t (один скаляр на голову) представляет, насколько должно обновляться состояние. Все значения в dt отрицательны, поскольку предыдущее состояние умножается на exp(Adt_t), состояние остается прежним, когда dt_t равно нулю. Архитектура Mamba-2 оптимизирует вычисления, позволяя эффективно вычислять скрытое состояние на различных контрольных точках последовательности. Следующий шаг — найти способ вычислить выходные данные, используя только начальное состояние. Это будет легко, если вычислять h_1, h_2, h_3, h_4, но это нарушит суть формулы перехода. Тем не менее, убирая убывающий член, цель состоит в том, чтобы вычислить выходные данные. Оптимизация производительности Mamba-2 включает в себя несколько ключевых улучшений, таких как аннотации операций загрузки и хранения с подсказками по задержке для моделирования трафика DRAM, а также автоматическое нахождение оптимальной конфигурации для каждой формы ввода с использованием autotuner cuTile-Python. Результаты показывают, что оптимизированные ядра прямого прохода cuTile в 1,14-1,82 раза быстрее, при этом ускорение увеличивается с ростом длины последовательности и размера состояния. Эти улучшения способствуют более эффективному использованию ресурсов и повышению производительности в задачах глубокого обучения. cuTile позволяет писать четкие, читаемые и высокопроизводительные ядра на Python. Следите за обновлениями, чтобы узнать о том, как реализован обратный проход в cuTile. Материал подготовлен нейросетью на основе оригинальной публикации. ИИ может ошибаться в деталях (цифры, имена, даты, цитаты) — для важной информации сверяйтесь с первоисточником.
Материал агрегирован из первоисточника:
SMNTCN (Semanticon) — глобальные новости ИИ
Читать полностью в SMNTCN (Semanticon) — глобальные новости ИИМатериал собран из открытых источников. Если размещение затрагивает ваши права → Удалить информацию
Оптимизация Mamba-2 с помощью высокопроизводительных ядер в NVIDIA CUDA Tile
NVIDIA CUDA Tile оптимизирует Mamba-2, улучшая производительность на GPU.
Кратко от AI: Главные тезисы
- NVIDIA CUDA Tile оптимизирует Mamba-2, улучшая производительность на GPU.
Оптимизация Mamba-2 с помощью высокопроизводительных ядер в NVIDIA CUDA Tile
Похожие материалы

Человек, изменивший мир искусственного интеллекта, едет в Казахстан
23 октября Астана впервые примет Дженсена Хуанга, основателя и генерального директора NVIDIA. Его визит интересен не только масштабом компании. Хуанг предлагает новое понимание мировой экономики, в которой искусственный интеллект становится производительной силой, вычислительные…
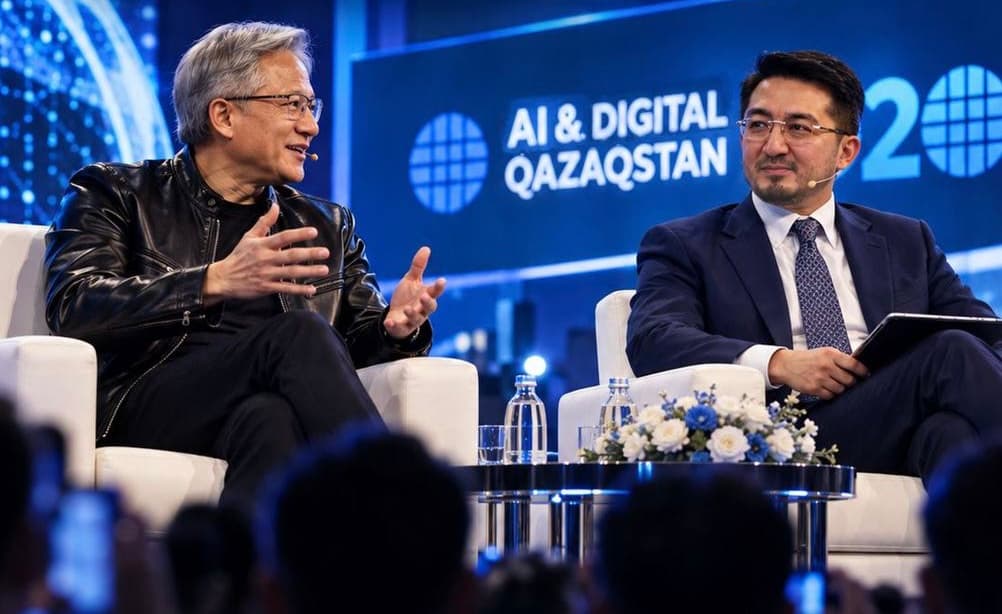
Дженсен Хуанг, глава NVIDIA, выступит с речью в Астане 23 октября
Основатель и генеральный директор NVIDIA Дженсен Хуанг примет участие в открытой дискуссии о будущем искусственного интеллекта в Астане 23 октября, сообщает Tech-news. На встрече в формате Fireside Chat он встретился с вице-премьер-министром РК, искусственным...
DeepSeek открыла исходный код DeepInfer - собственного движка для запуска ИИ-моделей.
DeepSeek открыла исходный код DeepInfer - собственного движка для запуска ИИ-моделей. Именно он обеспечивает работу DeepSeek-V4.1-Flash с высокой производительностью и минимальными задержками. Главное: - Ускорение инференса - больше запросов за меньшее время. - Эффективное…

ENA visit to Samsung’s massive new semiconductor hub
_____________ THE PLACE Pyeongtaek, South Korea Generative AI models run on powerful chips known as GPUs, which depend on stacks of specialized memory chips packaged with the processor. To meet growing demand for memory, Samsung is building a massive new semiconductor…